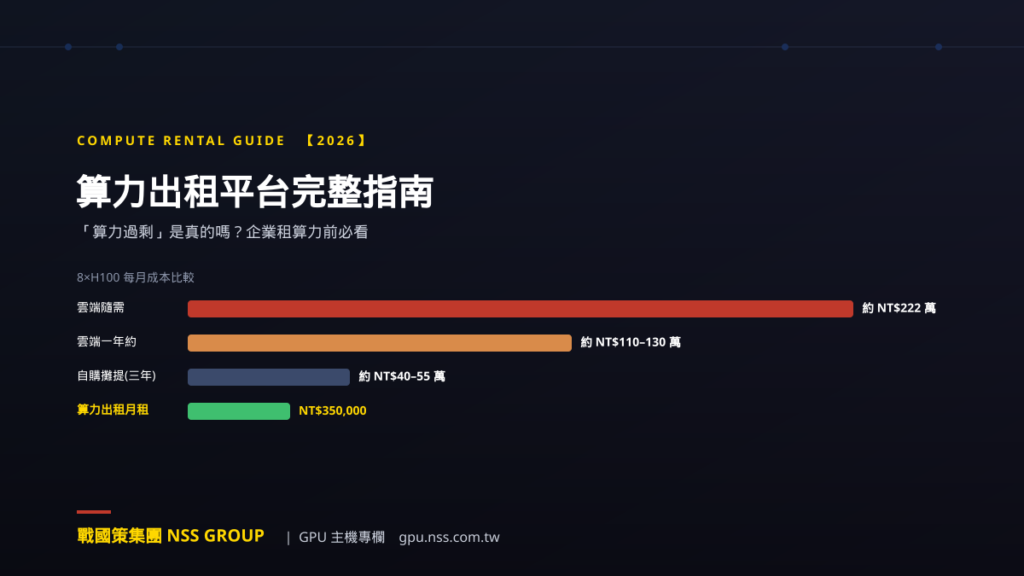
算力出租平台完整指南:企業租算力前必看
「算力過剩」是真的嗎?算力出租平台怎麼運作、怎麼評估?附8×H100每月成本比較(雲端隨需約NT$222萬 vs 算力出租月租NT$350,000),完整說明企業租算力前該問的問題。
「算力過剩」是真的嗎?算力出租平台怎麼運作、怎麼評估?附8×H100每月成本比較(雲端隨需約NT$222萬 vs 算力出租月租NT$350,000),完整說明企業租算力前該問的問題。
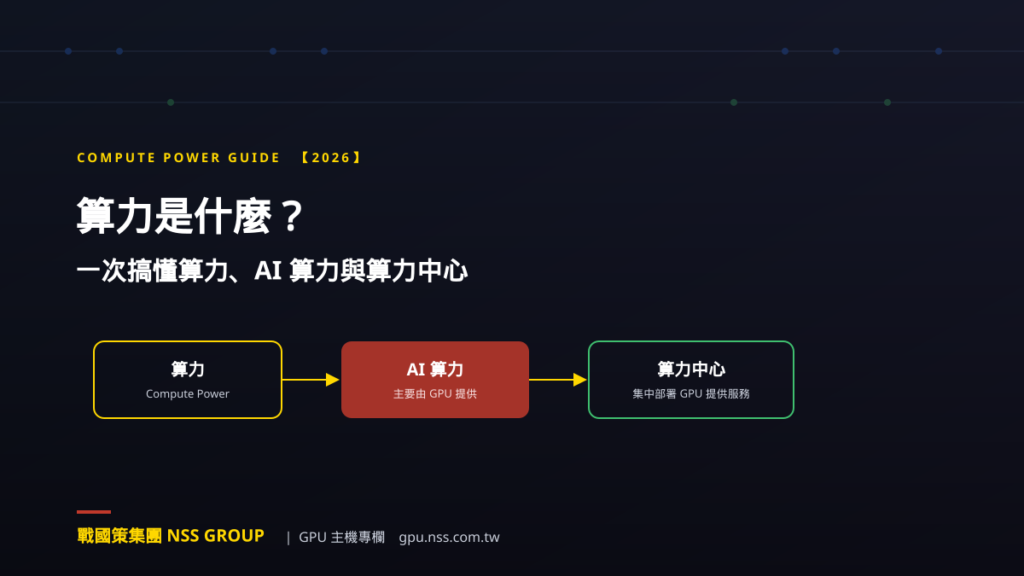
算力就是機器每秒能完成的運算次數,英文是 compute power。AI 算力特指訓練與執行 AI 模型所需的運算能力,主要由 GPU 提供。完整說明算力、FLOPS、算力中心的意思與企業何時該關心這件事。
GPU 租用平台怎麼比較?機房地點、規格透明度、MIG 切分方案、合約條件、SLA、服務模式、隱藏成本七個指標一次講清楚,附台灣市場實際月租行情與三種常見情境示範。
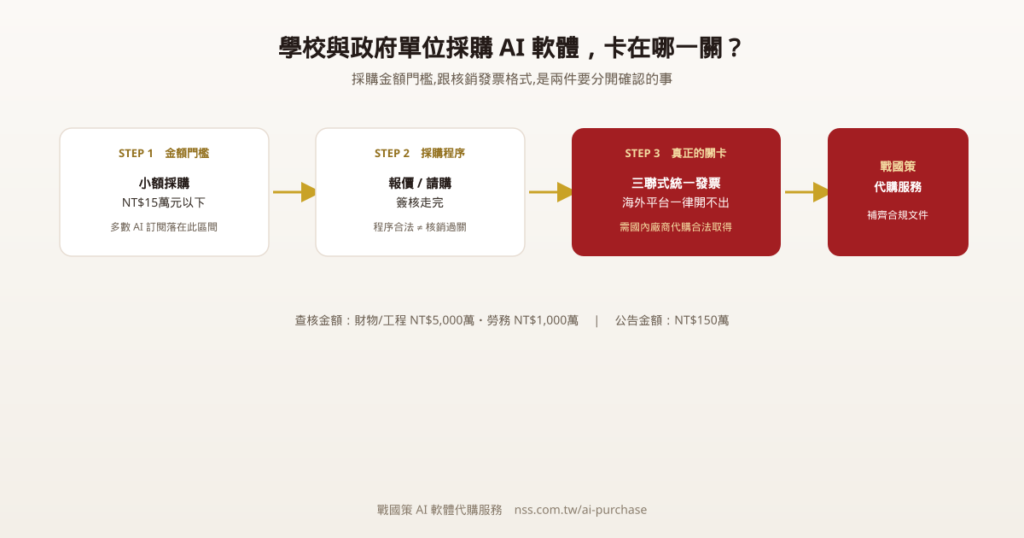
多數 AI 軟體訂閱落在小額採購門檻(NT$15萬)以下,程序相對單純,但核銷卡的是發票格式——海外平台一律開不出三聯式統一發票。完整說明採購金額門檻、核銷實務與解法。
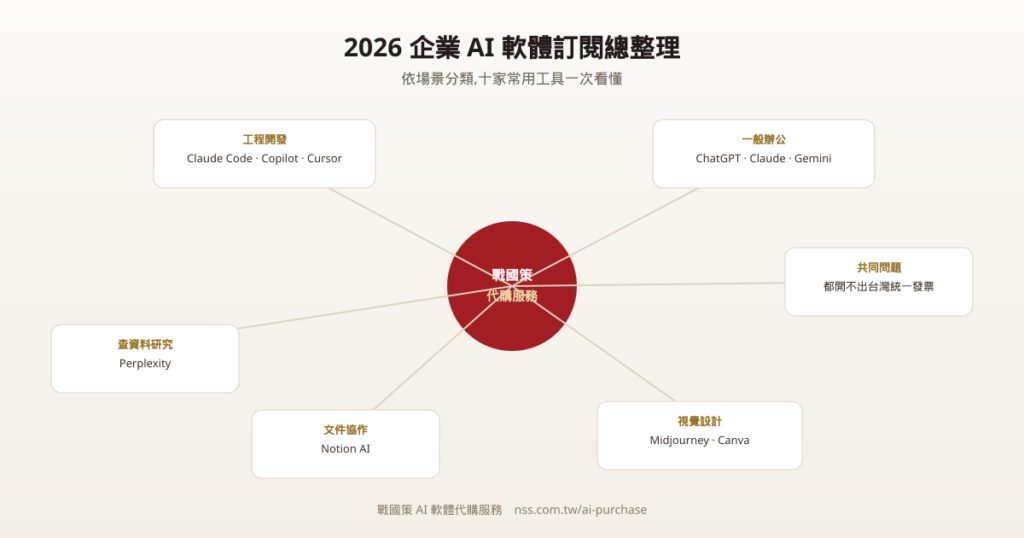
十家常用企業 AI 軟體(ChatGPT、Claude、Gemini、GitHub Copilot、Cursor、Notion AI、Perplexity、Midjourney、Canva)價格與計費邏輯一次比較,依工作場景找到合適的工具。
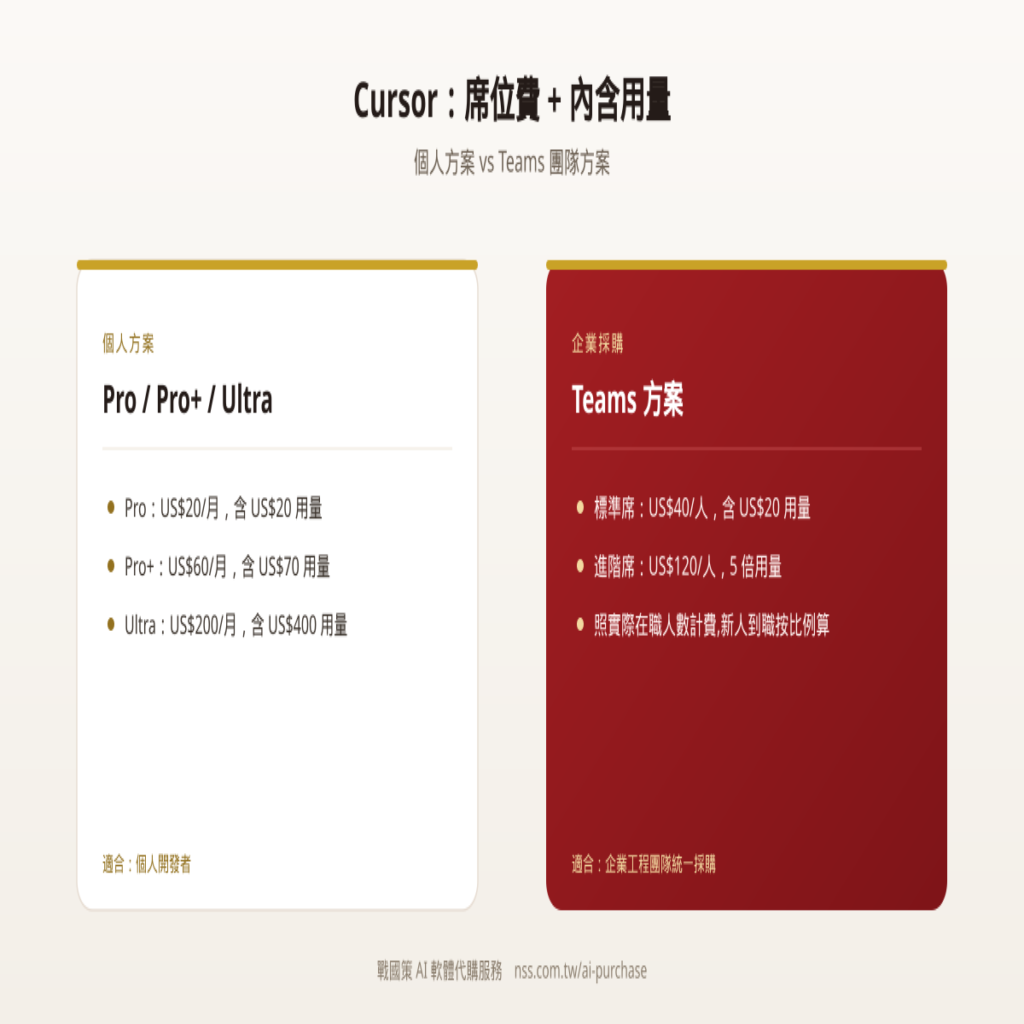
Cursor 是「席位費 + 內含用量」計費:個人 Pro US$20/月,團隊 Teams 標準席 US$40/人。完整比較個人與團隊方案價格,以及跟 GitHub Copilot、Claude Code 怎麼選。
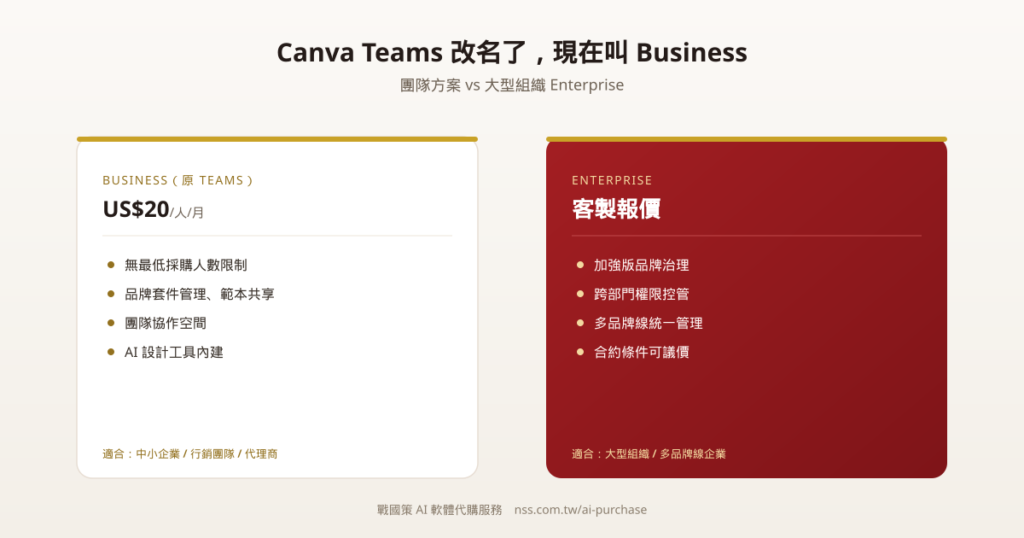
Canva Teams 已更名 Business,每人每月 US$20,無最低採購人數限制;規模更大才需要談 Enterprise 客製報價。完整說明方案內容與台灣企業採購常見問題。
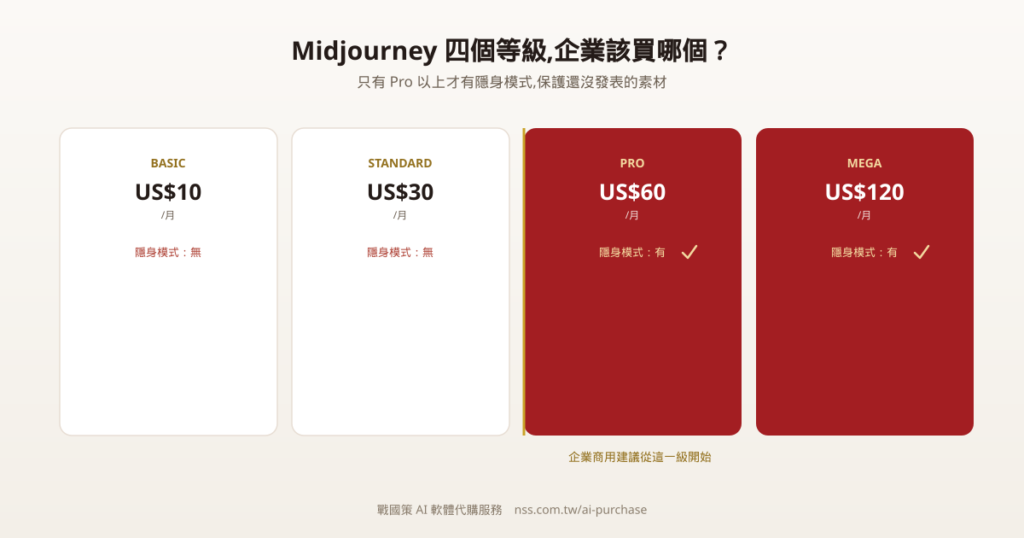
Midjourney 沒有獨立企業版,四個等級裡只有 Pro 以上才有隱身模式——保護還沒公開的商業素材。完整比較 Basic/Standard/Pro/Mega 價格與企業採購常見問題。
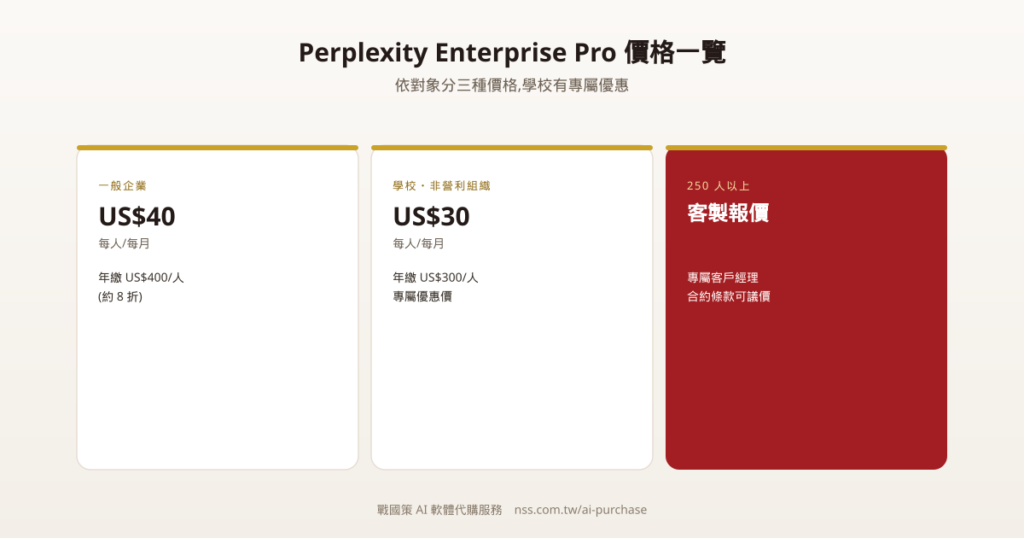
Perplexity Enterprise Pro 每人每月 US$40,學校與非營利組織享優惠價 US$30。適合需要頻繁查證外部資訊的研究、市調、輿情彙整團隊,完整說明價格與採購常見問題。
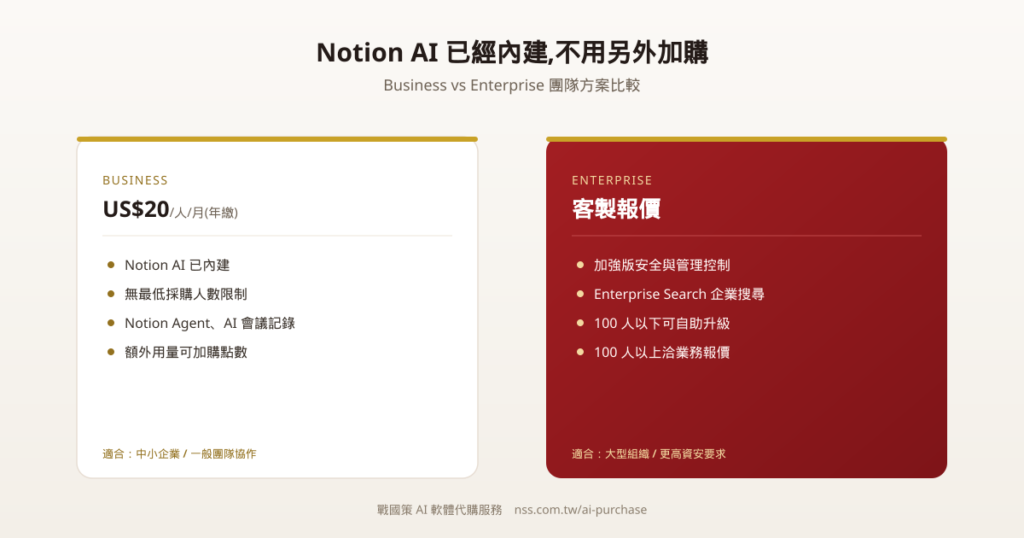
Notion AI 已經內建進 Business 與 Enterprise 方案,不再是獨立加購項目。Business 每人每月 US$20 無最低人數限制,完整說明方案內容與台灣企業採購常見問題。
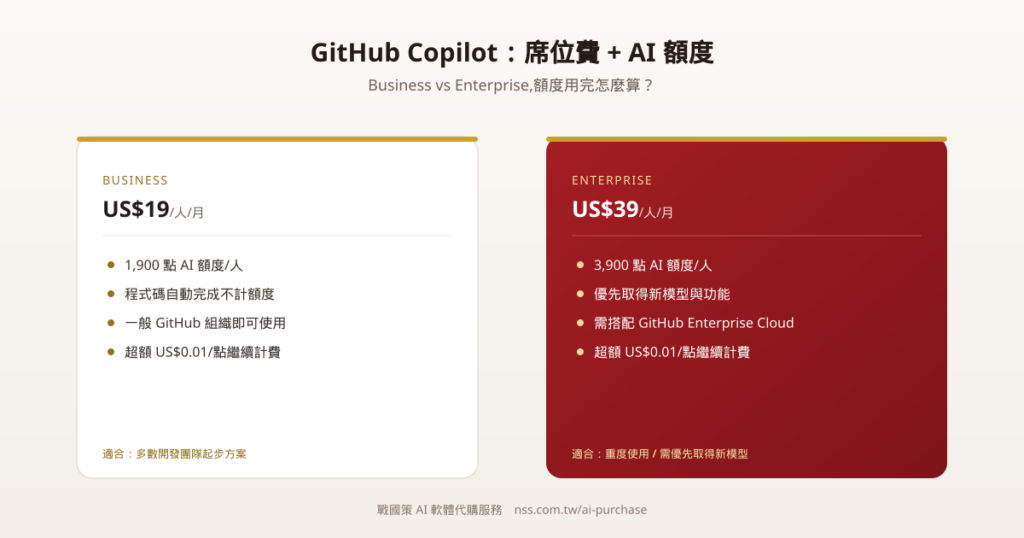
GitHub Copilot 企業採購是「席位費 + AI 額度」組合:Business US$19/人含 1,900 點額度,Enterprise US$39/人含 3,900 點。完整說明額度計費邏輯與台灣企業採購常見問題。
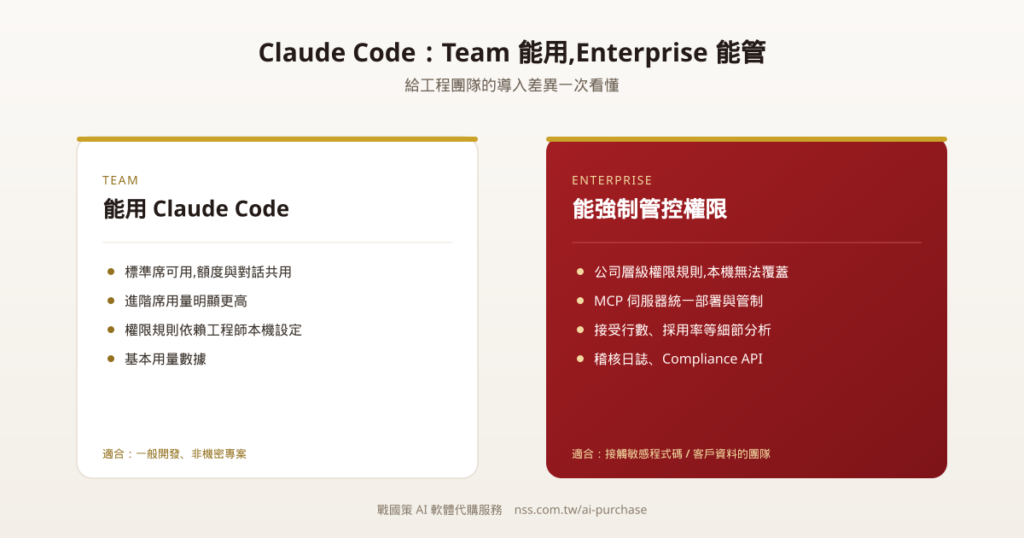
Claude Code 在 Team 方案就能用,但權限管控要到 Enterprise 才做得到——公司層級的受管理權限規則,工程師本機無法覆蓋。給工程主管的完整導入比較與準備清單。
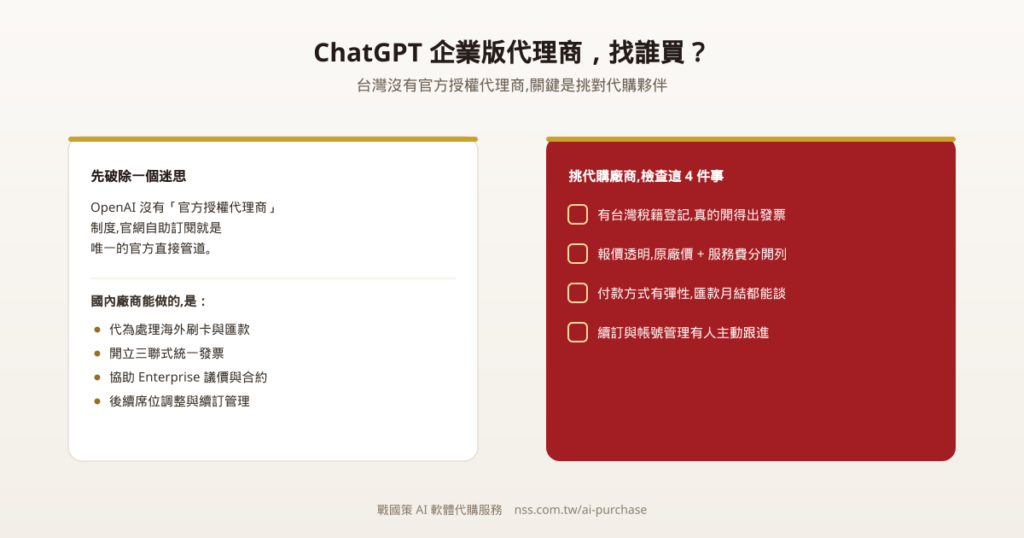
OpenAI 在台灣沒有官方授權代理商制度,官網自助訂閱就是唯一直接管道。本文說明代購廠商實際能提供的服務、怎麼挑選,以及 ChatGPT Business 席位該怎麼估。
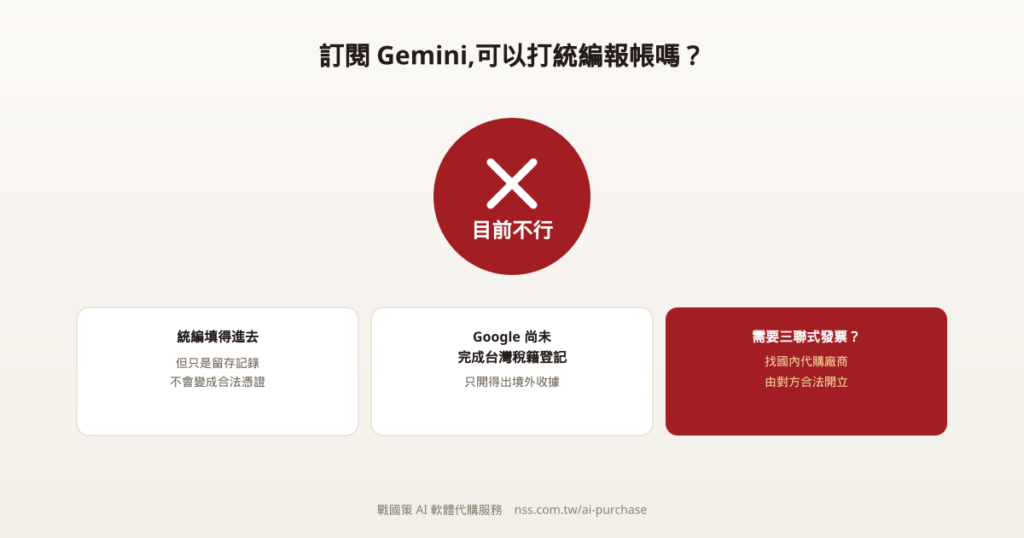
Gemini 訂閱目前填得進統編,但 Google 尚未在台灣完成稅籍登記,開不出台灣格式的統一發票。企業、學校與政府單位採購前,一定要先確認這件事。
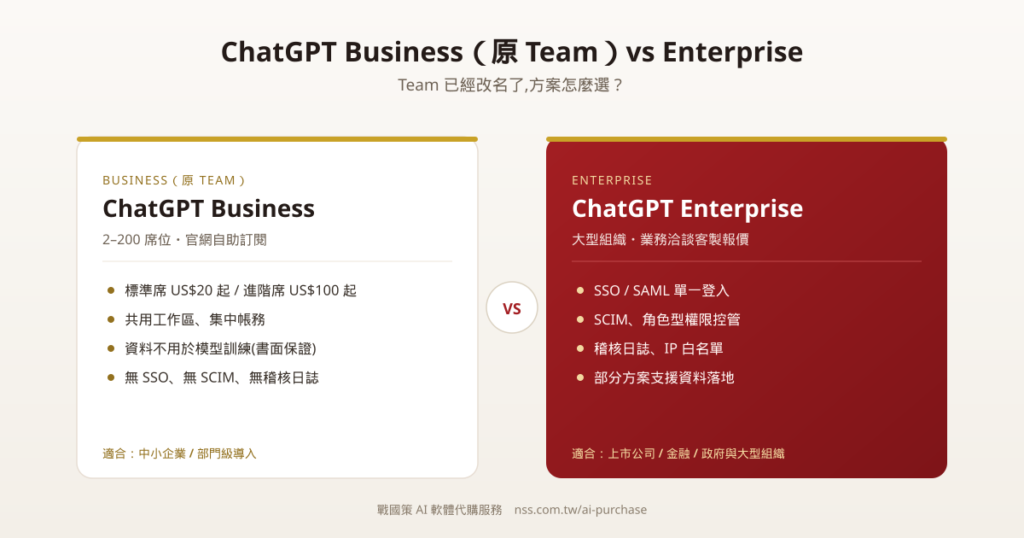
ChatGPT Team 已經改名為 Business,2 到 200 人官網自助訂閱即可;需要 SSO、稽核日誌這類合規功能才需要談 Enterprise。完整比較價格、席位規則與台灣企業採購常見問題。
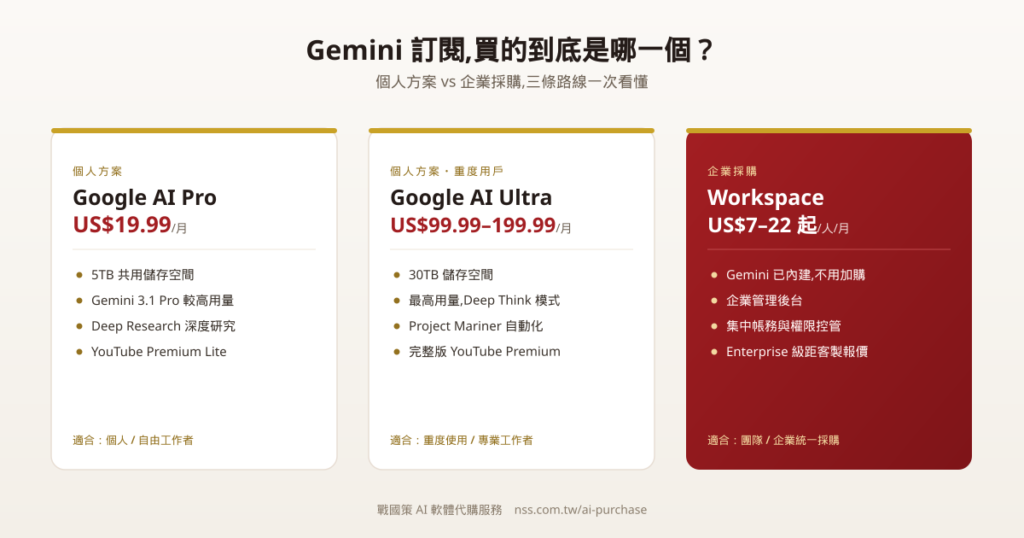
Gemini 訂閱其實有兩條路線:個人用戶看 Google AI Pro / Ultra,企業採購看的是 Google Workspace——Gemini 已經內建,不再是加購項目。完整拆解價格、功能與企業採購常遇到的問題。
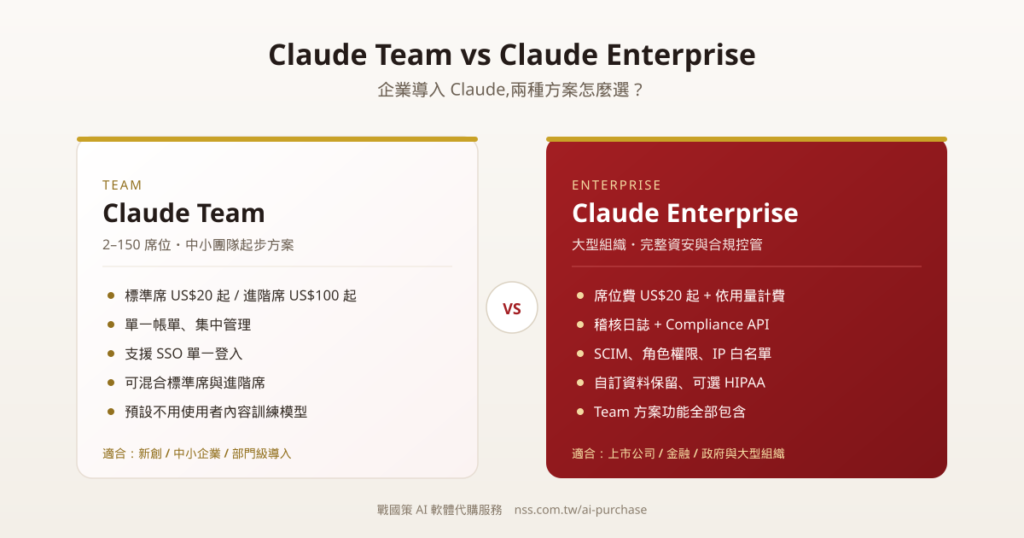
Claude Team 適合 2 到 150 人的團隊,固定席位費、自助訂閱;Claude Enterprise 才有稽核日誌、SCIM、IP 白名單等合規功能,採業務洽談與依用量計費。本文拆解價格、功能與選擇邏輯。
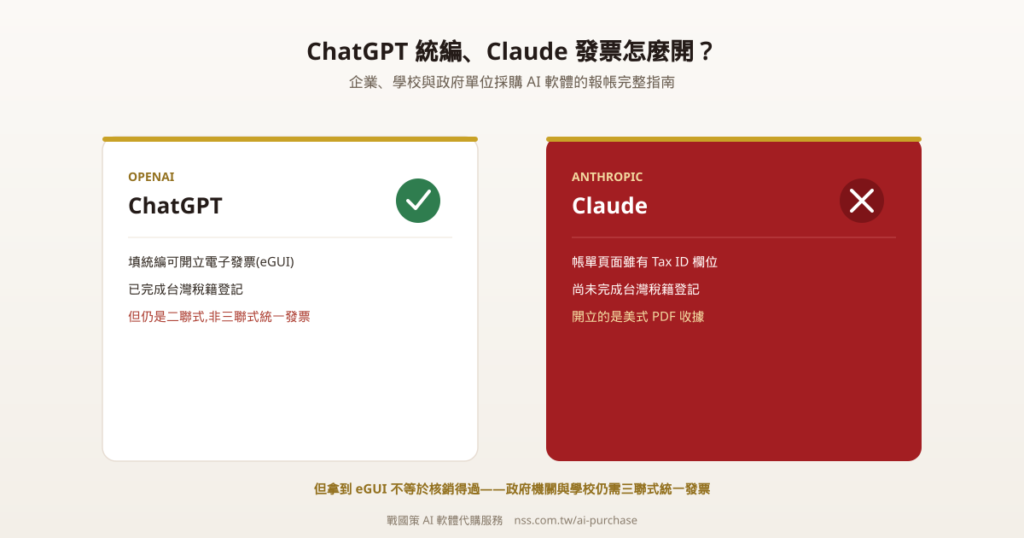
ChatGPT 已可填統編開立電子發票,Claude 仍只有美式收據。但拿到 eGUI 不等於核銷得過——政府機關與大專院校仍需國內廠商的三聯式統一發票與完整採購文件。本文說明每一關的實際狀況與解法。

SSL/TLS 憑證最長效期即將大幅縮短!根據 CA/Browser Forum 於 2025 年 4 月表決通過的 SC-081v3 決議,SSL/TLS 憑證最長效期將從原本的 398 天分三階段縮減:2026 年 3 月 15 日起縮短為 200 天(已生效)、2027 年 3 月 15 日起縮短為 100 天、2029 年 3 月 15 日起僅剩 47 天,等於未來每個月都要更新一次憑證。本文完整拆解三階段時程、對企業網站的實際衝擊,以及為什麼 ACME 自動化更新協定會成為企業唯一可行的解方,一步步教你提前部署,避免網站因憑證過期而中斷。若對 SSL 憑證的基本原理、種類與費用還不熟悉,建議先閱讀 SSL 憑證完整指南,再回頭看效期縮短對你的網站有什麼影響。 SSL/TLS 憑證效期為什麼要縮短到 47 天? 直接回答:因為憑證效期越長,私鑰外洩後可被濫用的時間窗口就越大。2025 年 4 月 11 日,全球憑證政策制定組織 CA/Browser Forum 針對由 Apple 提出的 SC-081v3 提案進行表決,Apple、Google、Mozilla、Microsoft 四大瀏覽器陣營全數投下贊成票;29 家憑證頒發機構(CA)中有 24 家贊成、5 家棄權、無任何一家反對,正式確立 SSL/TLS 憑證效期逐步縮短至 47 天的時程。 推動這項變革的核心理由有三個。第一是降低憑證被濫用的風險:長效期憑證一旦私鑰外洩或憑證遭冒發,攻擊者可以在長達一年以上的時間內用它散布惡意程式或發動中間人攻擊;縮短效期能直接壓縮攻擊者的可利用時間。第二是確保驗證資料的新鮮度:網域控制驗證(DCV)的重用期限也將同步縮短,2029 年起僅剩 10 天,確保憑證對應的網域所有權資訊隨時是最新狀態。第三是提升加密敏捷性:面對後量子密碼學的轉換需求,短效期憑證讓整個產業能更快汰換老舊的加密演算法。 SSL 憑證效期縮短三階段時程表是什麼? 最新整理如下:目前(2026 年)SSL 憑證最長效期已經從 398 天降為 200 天,接下來還有兩波縮短。企業可以對照下表,檢視自己的憑證管理流程能否承受更新頻率的倍增。 SSL/TLS 憑證效期縮短時程表(2026 最新版) 生效日期 憑證最長效期 DCV 驗證重用期 每年至少更新次數 2026/3/15 前 398 天(約 1

💡 快速答案:AI 模型訓練和推理的 GPU 需求差在哪裡? 訓練要同時保存權重、梯度、優化器狀態與激活值,顯存約權重的 8-10 倍:7B 全參數訓練要 110-140GB,還吃多卡互連,是 H100 的主場。推理只需權重加 KV cache:同個 7B 模型 FP16 只要 14-16GB,一張 RTX 4090 可服務,INT4 量化再省一半。搞混兩者最浪費預算。 「我們要導入 AI,該租什麼 GPU?」這個問題沒辦法直接回答,因為它少了一個關鍵前提:你要跑的是訓練,還是推理?這兩種工作負載對硬體的要求差異之大,大到同一筆預算可能差出十倍的效果。把推理的需求拿去租訓練級的 8 卡 H100,是把錢丟進水裡;拿一張消費卡硬跑全參數訓練,是把時間丟進水裡。這篇文章把兩種負載的本質差異、顯存計算方式、硬體選型邏輯一次講清楚,最後給出讓同一批 GPU 發揮兩倍價值的混合策略。不需要 ML 背景,看得懂乘法就能跟著算完每一筆帳。 本質差異:一個在學習,一個在服務 訓練是讓模型「學會」:資料前向傳播算出預測,跟標準答案比對出誤差,再反向傳播計算每個參數的梯度,由優化器更新權重——這個迴圈重複數萬到數百萬步。推理是讓模型「工作」:只有前向傳播,權重完全不動,吃進 prompt、吐出 token,一次一步。 這個差異決定了一切。訓練是吞吐導向的批次作業:在乎「多久跑完一輪」,可以中斷續跑,對延遲無感,但要為梯度與優化器狀態付出巨額顯存,多卡之間還要頻繁同步。推理是延遲導向的線上服務:在乎「使用者等多久」,全年無休不能斷,顯存需求小得多,但要面對併發起伏與尖峰。用一句話記:訓練買的是算力與互連,推理買的是顯存容量與穩定服務。 營運節奏的差異同樣關鍵:訓練是「專案」,有開始有結束,排程可以彈性挪動,失敗的代價是重跑;推理是「營運」,有 SLA、有使用者體驗、半夜掛掉要有人爬起來處理,失敗的代價是商譽。這決定了兩者連租賃形態都不同——訓練適合短租衝刺,用完即退;推理適合長租加備援設計。把這兩種節奏塞進同一台機器、同一張預算表,就是多數 GPU 規劃失敗的起點。 ▲ 7B 全參數訓練 110-140GB;推理 FP16 只要 14-16GB 顯存帳怎麼算:8-10 倍的差距從哪來 同一個 7B 模型,為什麼訓練要 110-140GB、推理只要 14-16GB?把顯存
「算力過剩」是真的嗎?算力出租平台怎麼運作、怎麼評估?附8×H100每月成本比較(雲端隨需約NT$222萬 vs 算力出租月租NT$350,000),完整說明企業租算力前該問的問題。
算力就是機器每秒能完成的運算次數,英文是 compute power。AI 算力特指訓練與執行 AI 模型所需的運算能力,主要由 GPU 提供。完整說明算力、FLOPS、算力中心的意思與企業何時該關心這件事。
GPU 租用平台怎麼比較?機房地點、規格透明度、MIG 切分方案、合約條件、SLA、服務模式、隱藏成本七個指標一次講清楚,附台灣市場實際月租行情與三種常見情境示範。
多數 AI 軟體訂閱落在小額採購門檻(NT$15萬)以下,程序相對單純,但核銷卡的是發票格式——海外平台一律開不出三聯式統一發票。完整說明採購金額門檻、核銷實務與解法。
十家常用企業 AI 軟體(ChatGPT、Claude、Gemini、GitHub Copilot、Cursor、Notion AI、Perplexity、Midjourney、Canva)價格與計費邏輯一次比較,依工作場景找到合適的工具。
Cursor 是「席位費 + 內含用量」計費:個人 Pro US$20/月,團隊 Teams 標準席 US$40/人。完整比較個人與團隊方案價格,以及跟 GitHub Copilot、Claude Code 怎麼選。
Canva Teams 已更名 Business,每人每月 US$20,無最低採購人數限制;規模更大才需要談 Enterprise 客製報價。完整說明方案內容與台灣企業採購常見問題。
Midjourney 沒有獨立企業版,四個等級裡只有 Pro 以上才有隱身模式——保護還沒公開的商業素材。完整比較 Basic/Standard/Pro/Mega 價格與企業採購常見問題。
Perplexity Enterprise Pro 每人每月 US$40,學校與非營利組織享優惠價 US$30。適合需要頻繁查證外部資訊的研究、市調、輿情彙整團隊,完整說明價格與採購常見問題。
Notion AI 已經內建進 Business 與 Enterprise 方案,不再是獨立加購項目。Business 每人每月 US$20 無最低人數限制,完整說明方案內容與台灣企業採購常見問題。
GitHub Copilot 企業採購是「席位費 + AI 額度」組合:Business US$19/人含 1,900 點額度,Enterprise US$39/人含 3,900 點。完整說明額度計費邏輯與台灣企業採購常見問題。
Claude Code 在 Team 方案就能用,但權限管控要到 Enterprise 才做得到——公司層級的受管理權限規則,工程師本機無法覆蓋。給工程主管的完整導入比較與準備清單。
OpenAI 在台灣沒有官方授權代理商制度,官網自助訂閱就是唯一直接管道。本文說明代購廠商實際能提供的服務、怎麼挑選,以及 ChatGPT Business 席位該怎麼估。
Gemini 訂閱目前填得進統編,但 Google 尚未在台灣完成稅籍登記,開不出台灣格式的統一發票。企業、學校與政府單位採購前,一定要先確認這件事。
ChatGPT Team 已經改名為 Business,2 到 200 人官網自助訂閱即可;需要 SSO、稽核日誌這類合規功能才需要談 Enterprise。完整比較價格、席位規則與台灣企業採購常見問題。
Gemini 訂閱其實有兩條路線:個人用戶看 Google AI Pro / Ultra,企業採購看的是 Google Workspace——Gemini 已經內建,不再是加購項目。完整拆解價格、功能與企業採購常遇到的問題。
Claude Team 適合 2 到 150 人的團隊,固定席位費、自助訂閱;Claude Enterprise 才有稽核日誌、SCIM、IP 白名單等合規功能,採業務洽談與依用量計費。本文拆解價格、功能與選擇邏輯。
ChatGPT 已可填統編開立電子發票,Claude 仍只有美式收據。但拿到 eGUI 不等於核銷得過——政府機關與大專院校仍需國內廠商的三聯式統一發票與完整採購文件。本文說明每一關的實際狀況與解法。
SSL/TLS 憑證最長效期即將大幅縮短!根據 CA/Browser Forum 於 2025 年 4 月表決通過的 SC-081v3 決議,SSL/TLS 憑證最長效期將從原本的 398 天分三階段縮減:2026 年 3 月 15 日起縮短為 200 天(已生效)、2027 年 3 月 15 日起縮短為 100 天、2029 年 3 月 15 日起僅剩 47 天,等於未來每個月都要更新一次憑證。本文完整拆解三階段時程、對企業網站的實際衝擊,以及為什麼 ACME 自動化更新協定會成為企業唯一可行的解方,一步步教你提前部署,避免網站因憑證過期而中斷。若對 SSL 憑證的基本原理、種類與費用還不熟悉,建議先閱讀 SSL 憑證完整指南,再回頭看效期縮短對你的網站有什麼影響。 SSL/TLS 憑證效期為什麼要縮短到 47 天? 直接回答:因為憑證效期越長,私鑰外洩後可被濫用的時間窗口就越大。2025 年 4 月 11 日,全球憑證政策制定組織 CA/Browser Forum 針對由 Apple 提出的 SC-081v3 提案進行表決,Apple、Google、Mozilla、Microsoft 四大瀏覽器陣營全數投下贊成票;29 家憑證頒發機構(CA)中有 24 家贊成、5 家棄權、無任何一家反對,正式確立 SSL/TLS 憑證效期逐步縮短至 47 天的時程。 推動這項變革的核心理由有三個。第一是降低憑證被濫用的風險:長效期憑證一旦私鑰外洩或憑證遭冒發,攻擊者可以在長達一年以上的時間內用它散布惡意程式或發動中間人攻擊;縮短效期能直接壓縮攻擊者的可利用時間。第二是確保驗證資料的新鮮度:網域控制驗證(DCV)的重用期限也將同步縮短,2029 年起僅剩 10 天,確保憑證對應的網域所有權資訊隨時是最新狀態。第三是提升加密敏捷性:面對後量子密碼學的轉換需求,短效期憑證讓整個產業能更快汰換老舊的加密演算法。 SSL 憑證效期縮短三階段時程表是什麼? 最新整理如下:目前(2026 年)SSL 憑證最長效期已經從 398 天降為 200 天,接下來還有兩波縮短。企業可以對照下表,檢視自己的憑證管理流程能否承受更新頻率的倍增。 SSL/TLS 憑證效期縮短時程表(2026 最新版) 生效日期 憑證最長效期 DCV 驗證重用期 每年至少更新次數 2026/3/15 前 398 天(約 1
💡 快速答案:AI 模型訓練和推理的 GPU 需求差在哪裡? 訓練要同時保存權重、梯度、優化器狀態與激活值,顯存約權重的 8-10 倍:7B 全參數訓練要 110-140GB,還吃多卡互連,是 H100 的主場。推理只需權重加 KV cache:同個 7B 模型 FP16 只要 14-16GB,一張 RTX 4090 可服務,INT4 量化再省一半。搞混兩者最浪費預算。 「我們要導入 AI,該租什麼 GPU?」這個問題沒辦法直接回答,因為它少了一個關鍵前提:你要跑的是訓練,還是推理?這兩種工作負載對硬體的要求差異之大,大到同一筆預算可能差出十倍的效果。把推理的需求拿去租訓練級的 8 卡 H100,是把錢丟進水裡;拿一張消費卡硬跑全參數訓練,是把時間丟進水裡。這篇文章把兩種負載的本質差異、顯存計算方式、硬體選型邏輯一次講清楚,最後給出讓同一批 GPU 發揮兩倍價值的混合策略。不需要 ML 背景,看得懂乘法就能跟著算完每一筆帳。 本質差異:一個在學習,一個在服務 訓練是讓模型「學會」:資料前向傳播算出預測,跟標準答案比對出誤差,再反向傳播計算每個參數的梯度,由優化器更新權重——這個迴圈重複數萬到數百萬步。推理是讓模型「工作」:只有前向傳播,權重完全不動,吃進 prompt、吐出 token,一次一步。 這個差異決定了一切。訓練是吞吐導向的批次作業:在乎「多久跑完一輪」,可以中斷續跑,對延遲無感,但要為梯度與優化器狀態付出巨額顯存,多卡之間還要頻繁同步。推理是延遲導向的線上服務:在乎「使用者等多久」,全年無休不能斷,顯存需求小得多,但要面對併發起伏與尖峰。用一句話記:訓練買的是算力與互連,推理買的是顯存容量與穩定服務。 營運節奏的差異同樣關鍵:訓練是「專案」,有開始有結束,排程可以彈性挪動,失敗的代價是重跑;推理是「營運」,有 SLA、有使用者體驗、半夜掛掉要有人爬起來處理,失敗的代價是商譽。這決定了兩者連租賃形態都不同——訓練適合短租衝刺,用完即退;推理適合長租加備援設計。把這兩種節奏塞進同一台機器、同一張預算表,就是多數 GPU 規劃失敗的起點。 ▲ 7B 全參數訓練 110-140GB;推理 FP16 只要 14-16GB 顯存帳怎麼算:8-10 倍的差距從哪來 同一個 7B 模型,為什麼訓練要 110-140GB、推理只要 14-16GB?把顯存