「算力」這個詞,兩年前還只在半導體業界的會議室裡出現,現在連沒碰過技術的老闆都會在會議上問一句「我們公司的算力夠不夠」。這篇把「算力」從頭講清楚——它到底是什麼、怎麼算、跟 AI 算力有什麼關係,以及為什麼這個原本冷門的工程詞彙,突然變成了全民熱搜字。
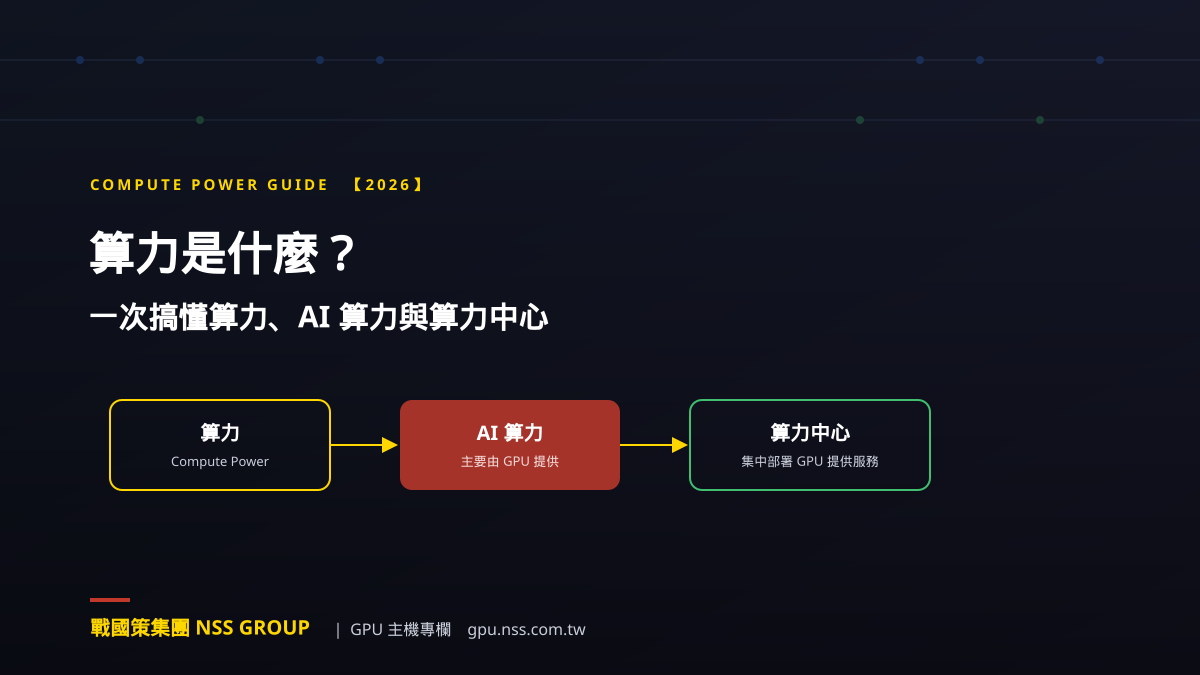
先講結論:算力,白話講就是「機器每秒能做多少次運算」,英文是 compute power 或 computing power。AI 算力特指訓練與執行 AI 模型所需要的運算能力,主要由 GPU 提供,而不是傳統的 CPU。搞懂這個定義,後面所有跟算力相關的討論才有共同的語言基礎。
算力到底是什麼:一個被過度神秘化的詞
拆開來看,「算力」就是「運算的能力」——衡量一台電腦、一顆晶片,或一整套系統,在單位時間內能完成多少次數學運算。這個概念一點都不新,從第一台電腦誕生開始就存在,只是過去很少被拿出來當成獨立的話題討論,因為多數應用程式對運算量的需求,遠遠低於硬體能提供的上限。
真正讓「算力」變成顯學的,是生成式 AI 的爆發。訓練一個大型語言模型,需要的運算量是傳統軟體開發的數萬倍甚至數百萬倍,一般辦公室電腦的 CPU 跑起來可能要花上好幾年才能完成一次訓練——這時候「算力夠不夠」就從一個工程師才關心的技術細節,變成了決定一家公司能不能做 AI 的關鍵資源問題。
算力怎麼算:認識 FLOPS
算力最常見的衡量單位是 FLOPS(Floating Point Operations Per Second,每秒浮點運算次數)。這個數字通常大到需要用科學記號表示,常見的單位前綴包括:
- TFLOPS(兆次)——每秒一兆次浮點運算,消費級顯卡的等級
- PFLOPS(千兆次)——每秒一千兆次浮點運算,資料中心級 GPU 叢集的等級
- EFLOPS(百億億次)——超級電腦與大型 AI 訓練叢集才會用到的規模
舉例來說,一張 NVIDIA H100 GPU 的理論運算能力,在特定精度下可以達到數百 TFLOPS 以上;訓練像 GPT 這個等級的大型語言模型,需要動用成千上萬張這樣的 GPU 同時運作數週到數月,累積起來的算力規模是 EFLOPS 等級。
AI 算力跟一般算力,差在哪裡
「算力」是個廣義詞,任何運算裝置都有算力,包括你手機裡的處理器。但「AI 算力」特指的是適合執行 AI 模型訓練與推論的運算能力,而這種運算有個特殊性質:AI 模型的核心運算是大量、重複、可平行處理的矩陣乘法,這正是 GPU 架構天生擅長的事情,而傳統 CPU 因為設計邏輯以循序處理為主,做這類運算的效率遠遠不如 GPU。
這也是為什麼「算力」討論到最後,幾乎都會收斂到「GPU 夠不夠」——不是所有的運算能力都叫算力,AI 語境下的算力,指的就是 GPU 算力。想擁有 AI 算力,買一百台一般伺服器不會有幫助,你需要的是配備 GPU 的專用硬體。
算力中心是什麼
「算力中心」指的是集中部署大量運算硬體(通常是 GPU 叢集)、提供運算服務的實體設施,概念上類似傳統的資料中心,但強調的重點是運算能力而不只是資料儲存與網路服務。傳統資料中心的規劃重點在儲存空間、網路頻寬與基本運算,算力中心則是圍繞著 GPU 密度、供電與散熱能力去設計——同樣坪數的機房,能塞進去、能穩定運作的 GPU 數量,直接決定了這個算力中心能提供多少算力。企業如果不想自己建置與維護硬體,可以透過租用算力中心裡的 GPU 資源來取得所需的運算能力,這也是「算力出租」這個商業模式的基礎。
算力相關詞彙對照表
| 詞彙 | 英文 | 白話解釋 |
|---|---|---|
| 算力 | Compute Power | 機器每秒能完成的運算次數 |
| AI 算力 | AI Compute | 執行 AI 模型訓練/推論所需的運算能力,主要靠 GPU 提供 |
| 算力中心 | Compute Center | 集中部署大量運算硬體、提供算力服務的設施 |
| FLOPS | Floating Point Operations Per Second | 算力的衡量單位,每秒浮點運算次數 |
| 算力出租 | Compute Rental | 透過租用而非自購取得算力的商業模式 |
為什麼「算力」突然變成全民關鍵字
三個原因疊加在一起,把算力從工程術語推上了新聞版面:第一,生成式 AI 的普及讓一般大眾第一次直接感受到「AI 需要很多運算資源」這件事;第二,全球晶片供應鏈的緊張(尤其是先進製程與高階 GPU),讓「算力」變成國家戰略層級的討論議題,連帶帶動投資市場對「算力概念股」的關注;第三,企業導入 AI 的過程中,幾乎每個部門都會遇到「我們的算力夠不夠」這個問題,從技術部門擴散到管理階層的日常用語。
算力、演算法、資料:AI 的三個基本要素
業界常用「算力、演算法、資料」這三個要素來描述 AI 發展的基礎條件,三者互為前提,缺一不可。資料是模型學習的原料,沒有足夠且乾淨的資料,模型學不到有用的能力;演算法決定模型怎麼從資料中學習、學到什麼樣的能力,是研究團隊的核心智慧財產;算力則是把演算法套用在資料上、真正跑出結果的執行力——同樣的演算法跟資料,算力不夠,訓練時間可能從幾天拉長到幾年,實務上根本無法完成。
近幾年 AI 領域的重大突破,很大一部分要歸功於算力的持續提升,讓原本理論上可行、但實務上跑不動的演算法變得可以真正落地。這也是為什麼「算力」會被視為 AI 競爭力的關鍵資源之一——演算法可以參考公開論文、資料可以逐步累積,但算力需要真金白銀的硬體投資或租用費用,是三個要素裡門檻最直接、最容易量化的一項。
企業什麼時候需要主動關心「算力」這件事
如果貴公司只是偶爾用用 ChatGPT 這類現成的 AI 服務,不需要特別關心算力議題,因為運算工作是由服務商在背後處理的。但如果貴公司要訓練自己的模型、微調現成模型,或是要建置對外提供服務的 AI 應用,算力就會變成一個具體要規劃的資源——需要多少張 GPU、什麼等級、要自購還是租用,這些問題都建立在對「算力」這個概念的正確理解之上。
用生活場景理解算力規模的差距
FLOPS 這種天文數字對多數人來說很難有實感,換個角度用「完成一件事要花多久」來感受規模差距會直觀許多。假設要訓練一個中型語言模型:用一台配備消費級顯卡的個人電腦,理論上可能要跑上好幾年才能完成,實務上根本不可行;换成一張資料中心級的 GPU(例如 H100),縮短到數週到數月;而換成上千張 GPU 組成的叢集同時平行運算,同樣的任務可能幾天甚至幾小時內就能完成。這就是為什麼企業級 AI 訓練幾乎不會考慮單機單卡,而是直接規劃多卡甚至多節點的叢集架構——不是為了炫技,是現實的時間成本逼出來的選擇。
這個對比也說明了「租用」相對「自購」的價值:多數企業的訓練需求是間歇性的——真正需要大規模算力的時候,可能一年只有幾次專案高峰,平常時間用不到那麼多資源。與其花大錢自購一套平常閒置的八卡叢集,不如在需要的時候租用,用完歸還,把資本支出轉換成營運支出。
算力不夠時,有哪些取得方式
企業發現自己算力不足時,大致有三條路可以走:自購硬體(資金投入最高,但長期持有成本可能較低,適合用量穩定且龐大的組織)、租用 GPU 主機(不需要一次性大筆資金,依需求彈性調整規模,適合多數中小企業與新創)、使用雲端 API 服務(不用管底層硬體,直接呼叫現成模型的 API,適合不需要客製化模型的應用)。三條路徑沒有絕對的優劣,取決於你的用量規模、資料敏感度與預算結構。
常見問題
算力是什麼意思?可以用白話解釋嗎?
算力就是機器每秒能完成的運算次數,白話講是機器的運算能力,英文叫 compute power 或 computing power。這個概念從電腦誕生就存在,只是過去多數軟體用不到硬體的運算上限,所以很少被單獨拿出來討論。近兩年因為生成式 AI 需要龐大運算量,訓練一個模型的運算量是傳統軟體的數萬倍甚至更多,算力才變成企業決策層也會關心的資源問題,而不只是工程師才懂的技術細節。
算力跟運算能力是同一件事嗎?
是同一件事,算力就是運算能力的簡稱說法,兩者可以互換使用。近年因為 AI 產業討論頻繁,算力這個詞被大量使用,逐漸變成比運算能力更常見的慣用詞,但意思完全相同,都是在講一台機器或一套系統單位時間內能完成多少次運算。看到文章用算力或運算能力,不需要當成兩個不同概念去理解,判斷重點永遠是這台設備每秒能處理多少運算工作。
AI 算力跟一般算力有什麼不同?
AI 算力特指執行 AI 模型訓練與推論所需要的運算能力,核心是大量且可平行處理的矩陣乘法運算,這正是 GPU 架構最擅長的工作,效率遠高於循序處理為主的傳統 CPU。所以討論 AI 算力時,幾乎都會收斂成 GPU 夠不夠這個問題,買再多一般伺服器也無法補足 AI 算力,因為傳統 CPU 做這類運算的效率遠遠不如 GPU,企業要的是配備 GPU 的專用硬體。
算力的英文怎麼說?衡量單位是什麼?
算力常見說法是 compute power 或 computing power,具體數值則用 FLOPS 表示,也就是每秒浮點運算次數。常見前綴有 TFLOPS 代表兆次,是消費級顯卡等級;PFLOPS 代表千兆次,是資料中心級 GPU 叢集等級;EFLOPS 則是超級電腦與大型 AI 訓練叢集才會用到的規模。舉例來說一張 H100 GPU 理論運算能力可達數百 TFLOPS 以上,訓練大型語言模型則需要 EFLOPS 等級的總算力。
外界說的算力過剩是真的嗎?企業該怎麼判斷?
要看討論的市場層級,部分消費級或舊世代中低階 GPU 型號,在新一代硬體推出後確實可能出現供給寬鬆,但高階 AI 訓練用的頂級 GPU,在可預見的未來仍處於供不應求。過剩的說法多半是針對特定型號或區域市場,不代表整體算力需求已經飽和。企業評估時不該被單一新聞標題左右,真正該問的是我需要的規格現在租不租得到、報價多少,而不是整體市場過剩還是短缺。
完全沒有技術背景的公司要怎麼開始規劃算力?
先從自己的實際用途反推,要跑什麼模型、資料量多大、多少人同時使用,再對照 FLOPS 或 GPU 張數這類規模單位去估算需求,而不是先去研究複雜的技術規格。不確定該怎麼估算的話,直接找有經驗的 GPU 主機服務商諮詢會更有效率,例如戰國策集團提供 GPU 主機方案與免費諮詢,可透過 0800-003-191 或 LINE 搜尋 @119m 直接討論實際用量。
算力中心跟一般資料中心差在哪裡?
算力中心指的是集中部署大量 GPU 叢集、以提供運算能力為主的設施,一般資料中心的規劃重點在儲存空間、網路頻寬與基本運算,算力中心則圍繞著 GPU 密度、供電與散熱能力去設計。同樣坪數的機房,能穩定塞進多少 GPU 直接決定這個算力中心能提供多少算力。企業不想自購硬體時,可以透過租用算力中心的 GPU 資源取得所需運算能力,這也是算力出租這種商業模式存在的基礎。
算力、演算法、資料這三者是什麼關係?
這三個要素互為前提缺一不可,資料是模型學習的原料,演算法決定模型怎麼從資料中學習,算力則是把演算法套用在資料上真正跑出結果的執行力。同樣的演算法跟資料,算力不夠訓練時間可能從幾天拉長到幾年,實務上根本無法完成。近幾年 AI 的重大突破很大一部分要歸功於算力提升,讓原本理論可行但實務跑不動的演算法真正落地,這也是算力被視為 AI 競爭力關鍵資源的原因。
企業什麼時候才需要主動關心算力這件事?
如果只是偶爾使用 ChatGPT 這類現成 AI 服務,不需要特別關心算力,因為運算工作由服務商在背後處理。但如果要訓練自己的模型、微調現成模型,或建置對外提供服務的 AI 應用,算力就變成要具體規劃的資源,包括需要多少張 GPU、什麼等級、自購還是租用。這幾個問題都建立在正確理解算力概念之上,越早釐清用量規模,後續採購或租用的決策才不會走冤枉路。
公司算力不夠時,自購、租用、雲端 API 該怎麼選?
三條路各有適用情境,自購硬體資金投入最高但長期持有成本可能較低,適合用量穩定龐大的組織;租用 GPU 主機不需一次性大筆資金,能依需求彈性調整規模,適合多數中小企業與新創;雲端 API 服務不用管底層硬體,直接呼叫現成模型,適合不需客製化模型的應用。多數企業的訓練需求是間歇性的,一年只有幾次專案高峰,租用能把資本支出轉換成營運支出,例如戰國策的 GPU 主機月租方案就是為這種需求設計。
延伸閱讀
戰國策 GPU 主機・戰國策 AI 伺服器
需要算力卻不想自購硬體?NVIDIA H100 GPU 主機台灣機房直供:MIG 切分卡月租 NT$15,000 起、2 小時部署、99.9% SLA、24 小時中文支援,從單卡到八卡叢集一次到位。