看 GPU 規格表時,最容易讓人放棄的就是那一長串 FLOPS 數字——「989 TFLOPS」到底是很強還是普通?跟另一張卡的「67 TFLOPS」比,差距是不是真的差了 15 倍?這篇教你把算力單位換算搞懂,以後看任何一份 GPU 規格表,都能自己判斷這台主機夠不夠用,不用完全依賴業務的說法。
先講結論:FLOPS 是「每秒浮點運算次數」,數字前面的字首(T、P、E)代表規模級距,每往上一級是一千倍;但同一張規格表上常常同時列出好幾種精度(FP64、FP32、FP16、INT8)的數字,精度不同,數字差距可以到幾十倍,比較時一定要看清楚是同一種精度,否則會算錯。
先搞懂字首:T、P、E 差在哪
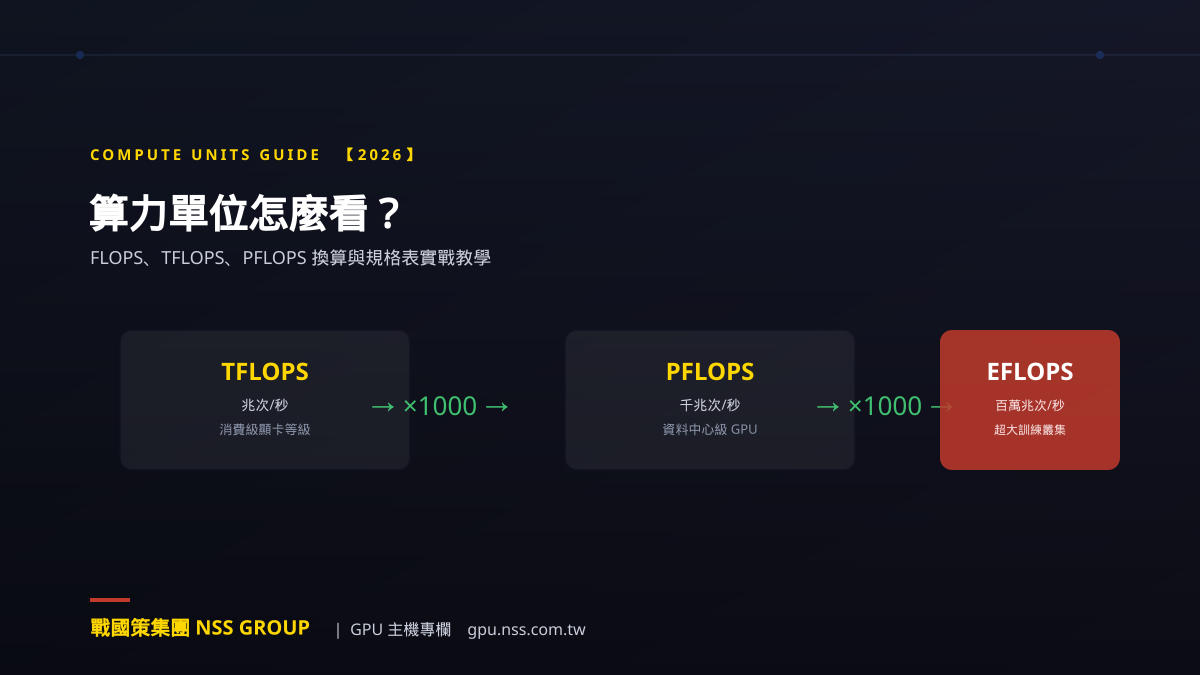
FLOPS 前面加上的字首,代表的是十進位的規模級距,跟電腦儲存單位常見的 KB、MB、GB 邏輯類似:
- TFLOPS(Tera,兆)——每秒一兆(10 的 12 次方)次浮點運算
- PFLOPS(Peta,千兆)——每秒一千兆(10 的 15 次方)次浮點運算,是 TFLOPS 的一千倍
- EFLOPS(Exa,百萬兆)——每秒百萬兆(10 的 18 次方)次浮點運算,是 PFLOPS 的一千倍
單張消費級顯卡的算力通常落在數十到數百 TFLOPS 等級;單張資料中心級 GPU(例如 H100)在特定精度下可以達到接近 1000 TFLOPS(也就是 1 PFLOPS);而訓練大型語言模型動用的整個 GPU 叢集,累積算力規模則是 EFLOPS 等級。
精度是什麼:為什麼同一張卡有好幾個 FLOPS 數字
浮點運算的「精度」,指的是電腦用多少個位元來表示一個數字,位元數越多,數字能表示的精確度越高,但運算速度越慢。常見的精度等級由高到低包括:
- FP64(雙精度)——科學運算、氣象模擬這類要求極高精確度的場景使用
- FP32(單精度)——傳統深度學習訓練的標準精度
- FP16 / BF16(半精度)——現代 AI 訓練與推論的主流精度,速度比 FP32 快,精確度損失在可接受範圍
- INT8 / FP8(低精度整數/浮點)——推論階段追求極致速度時使用,精確度犧牲最多
同一張 GPU,精度越低,理論 FLOPS 數字越大——因為犧牲了精確度,硬體能在同樣時間內做更多次運算。這也是為什麼規格表上同一張卡常常同時列出四、五個不同的 FLOPS 數字,差距可以到幾十倍。比較兩張卡的效能時,務必確認雙方比的是同一種精度,否則等於拿蘋果比橘子。
實際規格對照:常見 GPU 的算力數字
| GPU 型號 | 顯存 | 互連方式 | 適合場景 |
|---|---|---|---|
| RTX 5090 | 32GB GDDR7 | PCIe | 個人研究、輕量訓練 |
| H100 80GB | 80GB HBM3 | NVLink 900GB/s | 企業級訓練與推論 |
| H200 | 141GB HBM3e | NVLink 900GB/s | 超大模型、高吞吐推論 |
| H800 | 80GB HBM3 | NVLink(頻寬受限版) | 特定市場合規版本 |
不同世代 GPU 的算力演進,速度有多快
把時間軸拉長來看,資料中心級 GPU 每一到兩年就會有一次世代交替,算力提升的幅度相當驚人——從 A100 到 H100,再到 H200,同樣是頂規資料中心 GPU,在特定精度下的理論峰值算力可以有數倍的成長,顯存容量與頻寬也同步大幅提升。這代表兩件事:第一,規劃長期算力需求時,不能只看現在的硬體規格,要預留未來升級的彈性;第二,舊世代硬體不代表沒有價值——對很多中小規模的訓練與推論任務,前一世代的 GPU 效能早已綽綽有餘,反而在租用成本上更有優勢,不需要每次都追最新世代。
看規格表時,除了 FLOPS,還要看這兩個數字
FLOPS 只反映運算速度,實際跑 AI 工作負載時,另外兩個規格往往是效能瓶頸真正發生的地方:顯存頻寬(Memory Bandwidth)——決定資料進出 GPU 的速度,再快的運算單元,資料送不進來也是白搭;多卡互連頻寬(例如 NVLink 900GB/s)——多卡協作訓練時,卡與卡之間交換資料的速度,沒有高速互連,多卡的效能加成會大打折扣。評估一張 GPU 適不適合你的工作負載,FLOPS、顯存頻寬、互連頻寬三個數字要一起看,只看單一數字容易做出錯誤判斷。
實際案例:用 FLOPS 估算訓練時間
假設你要訓練一個中型語言模型,粗略估算所需的總運算量後,可以用「總運算量 ÷ 硬體實際算力」估出大概的訓練時間。這裡的關鍵是「實際算力」通常遠低於規格表上的理論峰值——實務上受限於資料讀取速度、軟體框架效率、多卡協作的通訊開銷,實際可用的算力利用率(MFU,Model FLOPS Utilization)常常只有理論峰值的三到五成。這也是為什麼同樣規格的兩套系統,實際訓練時間可能差到一倍以上——差距通常不是來自 GPU 本身,而是來自資料管線設計、軟體優化程度與多卡互連效率。評估一個平台或方案時,如果對方只給你理論峰值 FLOPS,卻講不出實際能達到的利用率,這個數字的參考價值其實有限。
企業實務上不需要自己精算 FLOPS
看懂這些單位是為了讓你在跟廠商溝通時聽得懂對方在講什麼、不會被隨便唬弄,但實務上規劃算力需求時,更務實的做法是從你要跑的模型與任務反推需要的硬體等級,而不是自己從 FLOPS 數字往上算——多數 GPU 主機服務商能依照你的模型規模與用途,直接建議適合的規格組合,比自己埋頭算數字有效率得多。
常見問題
FLOPS、TFLOPS、PFLOPS 之間怎麼換算?
換算邏輯跟儲存單位一樣是千倍遞增。FLOPS 是每秒浮點運算次數的基本單位,TFLOPS 是每秒一兆次運算,PFLOPS 是每秒一千兆次運算,等於一千個 TFLOPS,EFLOPS 再往上一千倍。單張消費級顯卡大約落在數十到數百 TFLOPS,資料中心級 GPU 例如 H100 在特定精度下可接近 1000 TFLOPS,也就是 1 PFLOPS,而訓練大型語言模型的整個叢集,累積算力則會到 EFLOPS 等級。
TFLOPS 越高的顯卡就一定越適合我嗎?
不一定,還要看顯存大小夠不夠放下你的模型與資料、互連頻寬夠不夠支援多卡協作,以及該精度是不是你實際會用到的。單看 FLOPS 數字選硬體,很容易買到規格用不上的配置。舉例來說,理論峰值很高但顯存頻寬不足的卡,實際跑訓練時可能被資料傳輸卡住,反而發揮不出帳面上的效能。
為什麼同一張 GPU 規格表會列出好幾個 FLOPS 數字?
因為精度不同,同一張卡的 FLOPS 數字可以差到幾十倍。精度指的是用多少位元表示一個數字,FP64 最精確但速度最慢,FP32 是傳統訓練標準,FP16 或 BF16 是現代 AI 訓練主流,INT8 或 FP8 犧牲精確度換取推論階段的極致速度。精度越低,理論算力數字越大。比較兩張卡的效能時,一定要確認雙方比的是同一種精度,否則等於拿蘋果比橘子,結論會完全失真。
FP16 訓練跟 FP32 訓練差在哪,為什麼大家都用 FP16?
FP16 用較少位元表示數字,運算速度更快、顯存佔用更少,現代深度學習框架搭配混合精度訓練技巧,能在幾乎不損失模型效果的前提下大幅提升訓練速度,因此成為業界主流做法。相對地 FP32 精確度較高但運算與顯存成本也高,通常只用在對精確度特別敏感的場景,一般大型模型訓練已經很少單獨使用純 FP32。
H100 的算力大概等於幾張消費級顯卡?
依精度與實際工作負載不同,粗略估計 H100 在資料中心優化的工作負載下,效能可以達到中高階消費級顯卡的數倍到十倍以上,加上企業級的穩定性、顯存容量與多卡互連能力,並非單純堆疊消費卡數量就能取代。實務上多卡協作還牽涉互連頻寬與軟體優化,消費卡堆疊起來的實際效能往往遠低於單張企業卡的表現。
除了 FLOPS,看 GPU 規格表還要注意什麼?
還要一起看顯存頻寬跟多卡互連頻寬,這兩個往往才是實際效能瓶頸所在。顯存頻寬決定資料進出 GPU 的速度,運算單元再快,資料送不進來也是白搭。多卡互連頻寬例如 NVLink 900GB/s,則決定多卡協作訓練時卡與卡之間交換資料的效率,沒有高速互連,多卡效能加成會大打折扣。評估一張 GPU 適不適合你的工作負載,FLOPS、顯存頻寬、互連頻寬三個數字要一起看。
MFU 是什麼,跟一般人有關係嗎?
MFU 是模型算力利用率,指實際訓練時真正用到的算力,佔硬體理論峰值算力的比例。這個數字對一般使用者不需要精算,但可以拿來判斷廠商或平台講的效能數字實不實在。實務上受限於資料讀取速度、軟體框架效率與多卡通訊開銷,實際利用率常常只有理論峰值的三到五成,如果對方只強調理論峰值卻避談實際利用率,通常代表沒有針對你的工作負載做過真正的效能驗證。
舊世代 GPU 還值得租用嗎,是不是一定要追新機種?
不一定要追最新世代,要看你的工作負載規模。資料中心級 GPU 每一到兩年就會世代交替,算力提升幅度驚人,從 A100 到 H100 再到 H200,理論峰值算力有數倍成長。但對很多中小規模的訓練與推論任務,前一世代的 GPU 效能早已綽綽有餘,租用成本上反而更有優勢。規劃長期需求時要預留升級彈性,但不必每次都追最新機種。
怎麼用 FLOPS 估算模型訓練需要多久時間?
用總運算量除以硬體實際算力可以粗略估出訓練時間,但關鍵是要用實際算力而非規格表理論峰值。實務上受限於資料管線設計、軟體框架效率與多卡通訊開銷,實際可用算力常常只有理論峰值的三到五成,這也是為什麼同樣規格的兩套系統,實際訓練時間可能差到一倍以上,差距通常來自軟體優化程度而非 GPU 本身。
租用 GPU 主機時需要自己精算 FLOPS 嗎?
不需要,看懂單位是為了跟廠商溝通時聽得懂對方在講什麼、不被隨便唬弄,但實務上更務實的做法是從你要跑的模型與任務反推需要的硬體等級。建議至少確認 GPU 型號、顯存大小與互連方式這三項基本規格。戰國策集團的 GPU 主機團隊能依照模型規模與用途直接建議適合的規格組合,H100 主機月租 NT$15,000 起,可撥打 0800-003-191 或加 LINE @119m 詢問。
延伸閱讀
戰國策 GPU 主機・戰國策 AI 伺服器
不用自己算 FLOPS,直接找懂規格的團隊:NVIDIA H100 GPU 主機台灣機房直供,MIG 切分卡月租 NT$15,000 起,2 小時部署、99.9% SLA、24 小時中文支援。